KI Challenge 2026: StatAgent und der Oktober, der keiner war
KI Challenge 2026: StatAgent rechnet eine Monatsstatistik ohne KI, gebaut in knapp 21 Stunden mit Coding-Agenten. Vorgehen, Zahlen, Learnings.
TL;DR
Bei der KI Challenge 2026 vom Dachverband der Sozialversicherungsträger und der Wirtschaftskammer Wien hab ich StatAgent gebaut. Allein, mit einer Flotte aus KI-Coding-Agenten. StatAgent macht aus monatlichen Lieferungen eine Beschäftigtenstatistik samt Qualitätsbericht. Der rote Faden, im Produkt wie in der Arbeitsweise: Die KI schreibt Code, das Programm rechnet, der Mensch gibt mit Namen frei. Von 24 Monaten sind 22 veröffentlicht, 53 von 76 Punkten der eigenen Abnahmeliste sind erfüllt. Die Demo läuft bis 6. Dezember 2026, der Code liegt offen.
Der Oktober, der keiner war
Vorweg das Wichtigste: Die Daten sind erfunden. Der Veranstalter hat synthetische Monatslieferungen bereitgestellt, in etwa ein Zehntel Österreichs, 24 Monate von August 2024 bis Juli 2026, zusammen 10.152.292 Zeilen. Die Fehler sind absichtlich drin, und die Regeln ändern sich unterwegs.
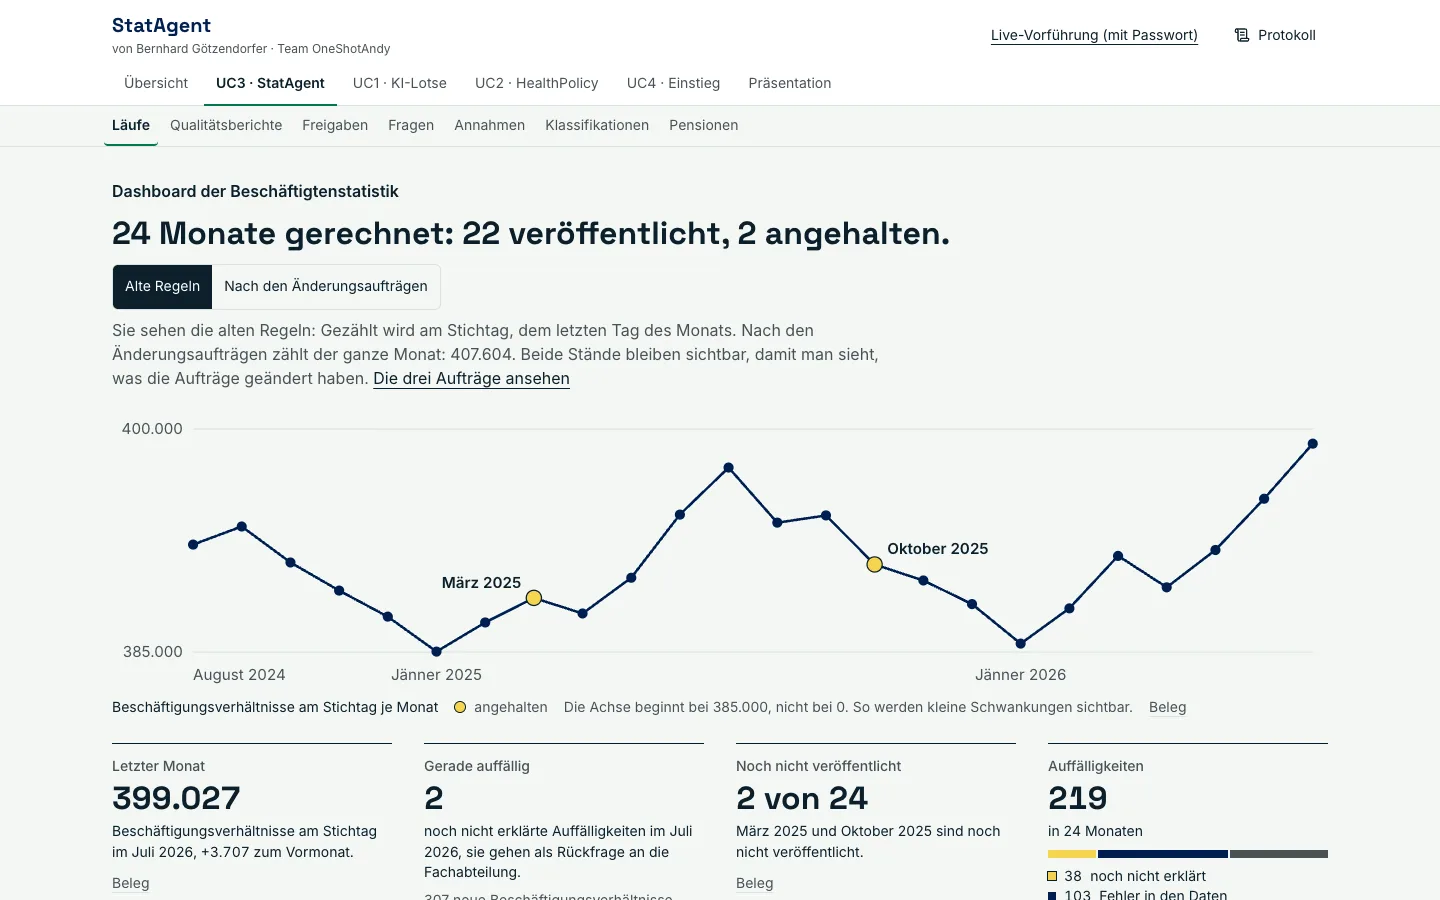
Dann kommt die Lieferung für Oktober 2025, und jedes fünfte Beschäftigungsverhältnis ist weg. 78.949 von 394.200, die Ende September noch bestanden haben, fehlen einfach. In einer Statistik schaut das aus wie ein Einbruch am Arbeitsmarkt.
StatAgent veröffentlicht diesen Einbruch nicht. Das Programm löscht nichts, markiert den Monat als vorläufig und hält ihn an. In der November-Lieferung sind 78.733 der fehlenden wieder da. Die Lieferung war unvollständig, der Einbruch war nie echt. Im Verlauf steht der Oktober deshalb gelb markiert, als angehalten, und nicht als Knick nach unten.
Was StatAgent macht
Use Case 3 der Challenge geht so: Die Sozialversicherung schickt jeden Monat eine große Tabelle mit allen Beschäftigungsverhältnissen. Daraus sollen eine Beschäftigtenstatistik und ein Qualitätsbericht werden. Diesen Use Case hab ich gewählt.
Das Programm liest jede Lieferung ein, prüft sie mit 24 festen Prüfregeln, zählt am Stichtag und schreibt den Bericht. Ein Sprachmodell kommt dabei nicht vor, im Monatslauf gibt es null Modellaufrufe. Bei gleichen Daten und Regeln kommt dasselbe heraus: 72 Wiederholungsläufe, jeder mit derselben Prüfsumme wie der Lauf davor. Der erste Anker war der Beispielbericht der Aufgabe für August 2024. 2.880 von 2.880 Zahlen darin lassen sich aus den Rohdaten nachrechnen.
Die KI kommt dort ins Spiel, wo sich Regeln ändern. Der Auftrag steht in einem Satz, etwa „Beamte zählen nicht mehr mit“. Ein Agent schreibt daraus einen Vorschlag für eine Regel. Das Programm rechnet den Monat einmal mit der alten, einmal mit der neuen Regel. In der Vorführung wurden aus 407.604 Beschäftigungsverhältnissen 395.315. Wirksam wird so eine Regel erst, wenn ein Mensch sie mit Vor- und Nachnamen freigibt. „Team“ oder „Admin“ gelten nicht. Die Freigabe landet im Protokoll und als Commit mit der Zeile Freigegeben-von, 29 solche Commits stehen im Repo.
Ganz sauber lief das nicht. Am Donnerstag hat eine KI-Session vier Freigaben stellvertretend für mich eingegeben. Ich hab sie um 18:22 selbst bestätigt (Commit 2ba95e5), und so steht es auch im README.
Die Grenzen stehen dort ebenfalls. 22 von 24 Monaten sind veröffentlicht, März und Oktober 2025 bleiben vorläufig. Nur August 2024 hat einen Vergleichsbericht. Von 76 Punkten der eigenen Abnahmeliste sind 53 erfüllt, 2 nicht erfüllt, 4 nicht geprüft und 17 erst nach der Abgabe dran. Das ist meine Prüfliste, nicht das Bewertungsraster der Challenge.
Vom Plan bis zur Abgabe
Mittwoch, der Vortag. Kein Produkt-Code. Stattdessen acht Rechercheberichte, ein Spielplan mit fester Entscheidungstabelle für den Use Case und Kürzungsregeln für den Fall, dass die Zeit nicht reicht. Im Team-Repo lagen nur ein README mit dem Vermerk „plan-only“ und ein Schutz, der Zugangsdaten aus dem öffentlichen Repo hält. Wie ich so eine Vorbereitung angehe, hab ich vor dem Hackathon im September aufgeschrieben.
Donnerstag, 12:00. Offizieller Start. Um 12:05 sag ich: „wir bauen erstmal noch nichts, wir planen jetzt alle Challenges“. Um 12:10 steht die Wahl als Commit fest, Use Case 3. Bis 12:48 entstehen sieben große Arbeitspakete und rund 90 Issues. Die ersten Produktbeschreibungen laufen als Merge Requests durch dieselbe Prüfung wie Code. Um 12:51 geb ich den Bau frei, um 13:02 kommt der erste Produkt-Code.
Ab 13:12 bauen sechs Sessions gleichzeitig, jede in einem eigenen Arbeitsbaum. Jede Datei gehört genau einem Bereich. Um 13:33 hat kein offener Merge Request einen Konflikt. Das Problem lag woanders: Jeder einzelne Merge zwang alle anderen offenen Merge Requests zum Nachziehen. Um 13:54 fällt der Entscheid für Bündel-Züge: Mehrere geprüfte Änderungen gehen gemeinsam auf main. Kurz davor, um 13:45, waren 6 gemergt und 11 offen. Um 14:17 waren es 20 gemergt und 6 offen.
17:40, „überladen“. Die Startseite ist seit 14:44 öffentlich. Am späten Nachmittag schau ich mir die Live-Seiten an und find sie überladen. Jede Seite erklärt sich selbst, bevor sie etwas zeigt. Alle Prüfungen waren grün. Daraus wird eine UI-Regie mit Veto: Fünf-Sekunden-Test, eine Hauptaussage und eine Hauptaktion je Bildschirm. Um 18:50 kommt eine zweite Prüf-Bank dazu, weil die Prüfung der Engpass war, nicht die CI.
23:26, die Generalprobe. Die Vorführung für Freitag wird einmal komplett durchgespielt. Sie scheitert beim Schritt „festschreiben“: Die Datenbank der Vorführung bricht ab, weil sie im Container einen verwaisten Prüfprozess geerbt hat. Fix, neuer Durchlauf, um 23:46 bestanden. Ohne die Probe wäre die App am Morgen gestanden.
00:35 fällt der zweite Mac aus. Die Ursache war in der Nacht nicht messbar. Die Prüfungen ziehen auf den CI-Server um, der Ersatz war über eine einzige Einstellungsdatei vorbereitet. Dort besteht von 03:04 bis 03:59 der Weg, den die Jury gehen würde, auf einem frischen Klon.
Freitag in der Früh. Kurz vor sechs schau ich mir die App selbst an und find sie unvollständig. Drei Audits geben mir recht. Von 05:37 bis 06:07 läuft der Schlusslauf der Abnahme auf einem festen Stand, um 06:30 ist Merge-Stopp, um 07:00 Feature-Stopp. Von 07:55 bis 08:02 gehen 67 Ergebnisdateien in den Teamordner, danach wird jede mit Prüfsumme zurückgelesen: 0 Differenzen. Um 09:00 ist Abgabe.
Wer was gemacht hat
Die KI schreibt Code, das Programm rechnet, der Mensch gibt frei. Das gilt nicht nur für StatAgent, sondern auch dafür, wie er entstanden ist.
Ich hab entschieden, was gebaut wird, und fachlich freigegeben. Jede Bau-Session lief mit session-orchestrator, meinem Open-Source-Plugin für Claude Code: vereinbarter Plan, Prüfung nach jeder Runde von Unter-Agenten, Übergabe an die nächste Session. Eine Lead-Session hat die Arbeit verteilt, geprüfte Änderungen gebündelt, gemergt und ausgeliefert. Die Bau-Sessions haben gebaut und nie selbst gemergt. Eine Prüf-Bank hat die Merge Requests gegengelesen, Claude Opus und Codex parallel, rund vier Minuten je Stand. In der Nacht gingen einzelne Änderungen auch direkt auf main. Eine eigene Abnahme-Session hat jedes Kriterium mit Befehl, Ausgabe und Commit gemessen. Dazu kam ab dem Abend die UI-Regie.
Von der Wahl des Use Case um 12:10 bis zur Abgabe um 09:00 waren es 20 Stunden 50 Minuten. In diesem Zeitraum entstanden 1.500 Commits auf main und 351 Merge Requests, Bündel-Züge mitgezählt. Mit Vorbereitung und Nacharbeit sind es insgesamt 1.587 Commits und 377 Merge Requests, dazu 839 Pipelines, gemessen am Freitag gegen Mittag. Gemeinsame Arbeit mit Agenten, unter meinem Namen.
Was ich mitnehme
Grün heißt nicht verständlich. Die Prüfungen messen Muster, Barrierefreiheit und Zahlen. Ob jemand eine Seite in fünf Sekunden versteht, messen sie nicht. Das hab ich zweimal gesehen, um 17:40 und kurz vor sechs in der Früh. Beim nächsten Mal schau ich früher und öfter selbst auf die Live-Seite, nicht erst, wenn alles grün ist.
Der Engpass ist der Merge, nicht das Schreiben. Die CI-Jobs liefen in 8 bis 30 Sekunden, Wartezeit 0 bis 3 Sekunden. Geschrieben war schnell. Teuer war, dass jeder einzelne Merge alle anderen ungültig machte, und dass eine Prüf-Bank für sechs Sessions nicht reicht. Beim nächsten Mal gibt es beides von Anfang an.
Die Generalprobe gehört vor die Nacht. Die Probe um 23:26 hat den Absturz gerade noch erwischt. Nächstes Mal probe ich am Nachmittag. Genauso braucht jeder Rechner einen vorbereiteten Ersatz, der nicht erst um Mitternacht erfunden wird.
Rechnen im Code macht Zahlen nachprüfbar. Weil kein Modell rechnet, kann jeder mit den Rohdaten die 2.880 Zahlen nachrechnen und bekommt dasselbe Ergebnis. Eine Rechnung, die für August passt, wird deswegen aber noch keine Regel für alle Monate.
Ein Agenten-Urteil ist ein Vorschlag. Die Abnahme hat anfangs zu früh „bestanden“ gemeldet, gefunden haben das zwei unabhängige Reviews. Am Donnerstag waren über ein Dutzend gemeldete Befunde falsch, weil der Befund älter war als der Stand, gegen den gemessen wurde. Seitdem gilt: erst Befehl und Ausgabe lesen, dann gegen main prüfen. Ein anderer Agent hat sich geweigert, eine Freigabe unter fremdem Namen einzutragen, auch auf Anweisung der Lead-Session. Zu Recht.
Speicher und Kontext brauchen einen Wächter. Kurz nach Baustart hat ein lokaler Embedding-Versuch rund 28 GB Speicher belegt, dazu 14 GB Swap. Bemerkt hab ich es selbst, ein Wächter griff nicht, weil die Prüfung in keiner der sechs Bau-Sessions lief. Und der Kontext der Lead-Session wächst schnell: Bei 680.000 bis 920.000 Tokens hat jeweils eine neue übernommen, mit Übergabedatei. Bis zum Ende waren es neun Lead-Sessions.
Ausprobieren
Die Demo ist bis 6. Dezember 2026 online, lesend. Die KI-Funktionen laufen über Zugänge des Veranstalters und gehen in den nächsten Tagen offline, Zahlen, Berichte und Freigaben bleiben. Der Qualitätsbericht für Oktober 2025 zeigt, warum der Monat angehalten ist, und eine Freigabe zeigt den Monat mit alter und neuer Regel. Der Code liegt auf GitHub, samt einer Werkstattbeschreibung der Arbeitsweise mit Rollen, Regeln und dem, was schiefging.
Für die Top 3 hat's bei mir nicht gereicht. Alle drei Stockerlplätze gingen an Teams der HTL Spengergasse, die Jugend hat komplett abgeräumt. Gratulation!
Muamer Haznedarevic hab ich dort kennengelernt. Wir sind fast die ganze Zeit nebeneinander gesessen, und der Austausch zwischendurch war das Beste an der Nacht. Danke dafür. Danke auch ans Orga-Team und an die Jury, und Grüße an alle anderen Teams.
Wie das beim letzten Hackathon im September war, steht im Recap zum Pflegegeld-Prüfer.