HACK_002 in Wien: Pflegegeld-Prüfer gewinnt Track A1
Recap zu HACK_002 in Wien: Der Pflegegeld-Prüfer gewinnt Track A1, mein vorher festgelegtes Ziel von 12 aus 14 Gerichtsfällen verfehlt er aber. Er schafft 10.
TL;DR
Bei HACK_002 im HOIV, dem Home of Innovation in Wien, hab ich den Pflegegeld-Prüfer gebaut, und er hat Track A1 gewonnen. Du erzählst einen normalen Pflegetag, der Prüfer rechnet nach, ob die Stufe im Bescheid passt. Mein vorher festgelegtes Ziel waren 12 von 14 Gerichtsfällen, geschafft hat er 10. Beides steht auf der Website. Online ist er unter www.pflegegeld-pruefer.at, gratis und ohne Werbung.
Abgeschickt, während ich geschlafen hab
Sonntag, 04:54. Die letzte Nachaufnahme fürs Einreichvideo ist im Kasten. Zwei Minuten später geb ich die Abgabe schriftlich frei. Dann leg ich mich hin.
Um 05:58 schickt ein Agent die Abgabe ab: ZIP, Video, Formular. Ich hab da schon geschlafen. Die Deadline wäre um 08:30 gewesen.
Um zwölf hab ich den Prüfer live vorgeführt. Track A1, "Applied AI for Consumers", ging an den Pflegegeld-Prüfer. Gebaut haben 65 Leute in 25 Teams. Dass es gereicht hat, ohne dass ich das Ziel nachträglich verschoben hab, freut mich ehrlich gesagt sehr.
Und das Einreichvideo hatte Ton. Bei meinem ersten Hackathon im März war genau das schiefgegangen.
Rosa, 81, und drei Pullover
Pflegegeld gibt es in Österreich in sieben Stufen. Welche Stufe jemand bekommt, hängt vor allem an den Stunden Pflegebedarf im Monat. Wer eine Stufe zu tief eingestuft ist, verliert jeden Monat Geld. Von Stufe 3 auf Stufe 4 sind das aktuell 295,90 Euro.
Passiert das oft? Vorab haben meine Agenten 29 veröffentlichte Gerichtsfälle samt Bescheid ausgewertet. In 13 davon hat das Gericht am Ende eine höhere Stufe festgelegt als der erste Bescheid, in keinem eine niedrigere. Über die Behörden insgesamt sagt das wenig. Vor Gericht landen nur strittige Fälle, und veröffentlicht wird davon wieder nur ein Teil.
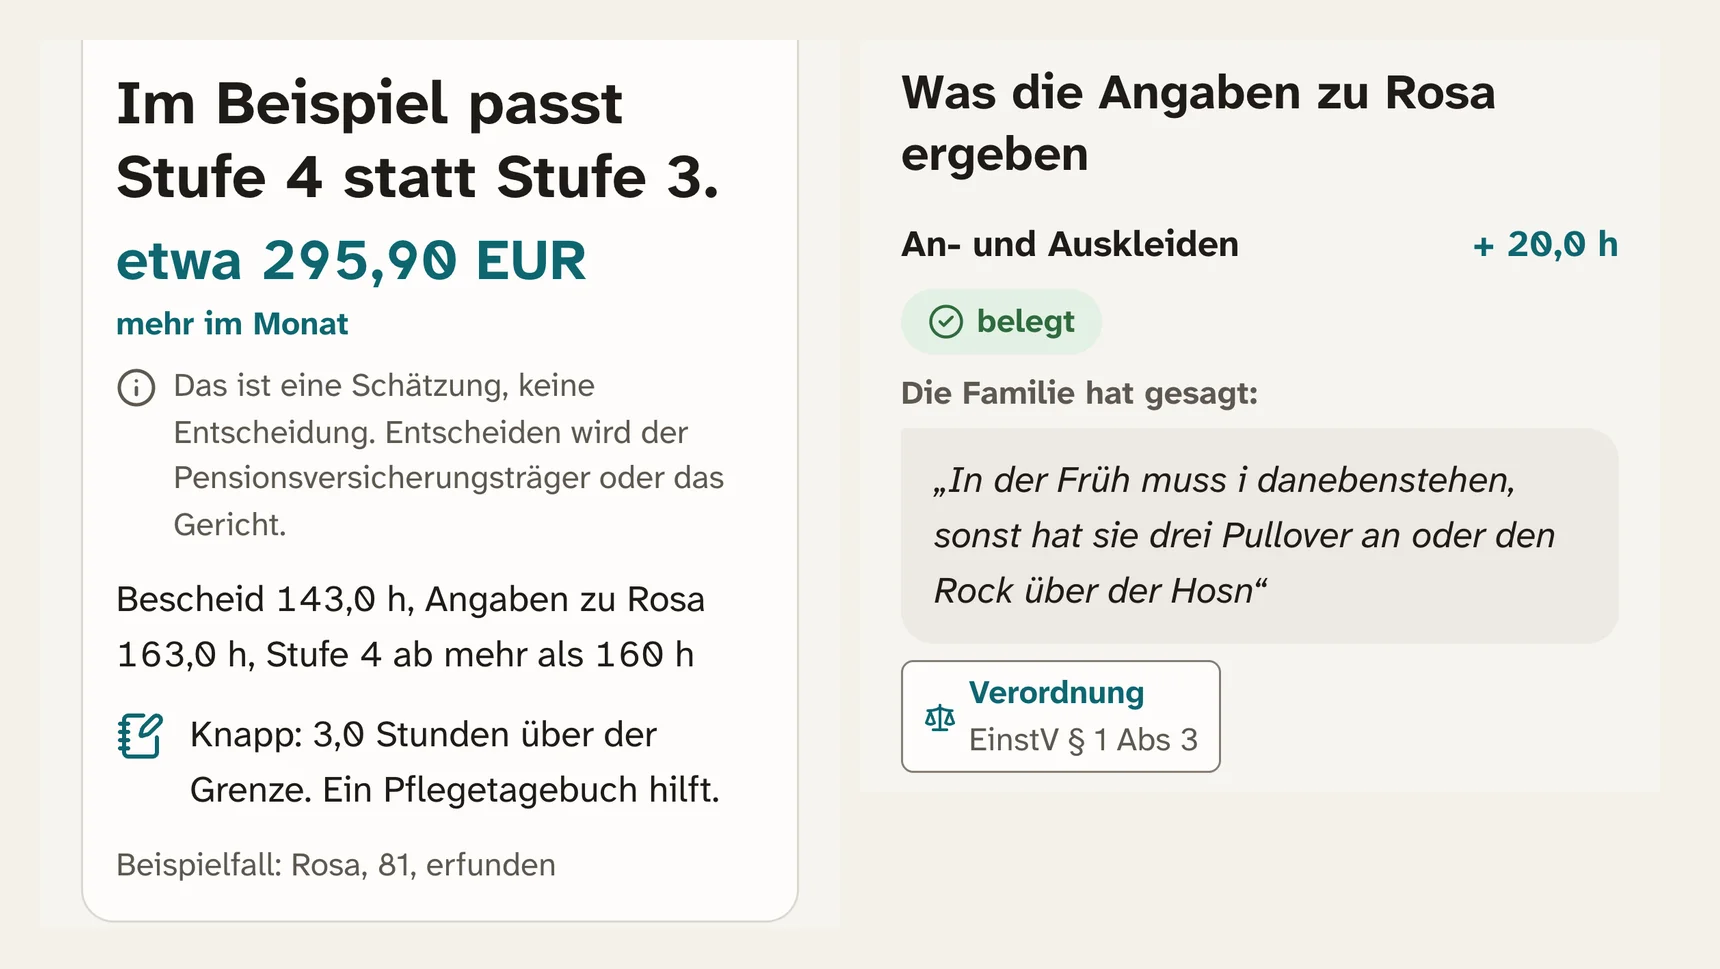
Der Prüfer dreht das Formular um. Statt Kästchen anzukreuzen, erzählst du einen normalen Tag, so wie du halt redest. Rosa ist 81 und erfunden, wie alle Beispielfamilien. Ihre Tochter erzählt: "In der Früh muss i danebenstehen, sonst hat sie drei Pullover an." Ein Sprachmodell ordnet jeden Satz einer Regel aus Gesetz und Einstufungsverordnung zu und muss den Satz dabei wörtlich zitieren. Der Code prüft jedes Zitat. Eine Zeile ohne wörtliches Zitat zählt nicht.
Gerechnet wird nur im Code: Stunden, Stufe, Euro im Monat und die Frist für eine Klage. Keine einzige Zahl kommt vom Modell. Der Claim auf der Startseite sagt es in zwei Sätzen: "Erzählen statt ankreuzen. Die KI hört zu, der Code rechnet nach."
Dialekt hab ich nur nebenbei gemessen. Sieben erfundene Fälle wurden in Dialekt umgeschrieben, bei keinem hat sich die Stufe geändert. Vorregistriert war das nicht, deshalb steht es hier nur als Randnotiz.
Das Ergebnis ist eine Schätzung, keine Entscheidung. Es bereitet ein Beratungsgespräch oder die nächste Begutachtung vor, Rechtsberatung ist es keine. In 54 Sekunden schaut das so aus:
22 Minuten zu früh
Im Vorher-Post vom 23.09. hab ich geschrieben, dass es vor dem Opening kein Repository gibt. Da muss ich mich kurz selbst ausbessern.
Das Repository gab es ab Samstag 08:25, nur mit Dokumenten, ohne eine Zeile Code. Code geschrieben wurde ab 11:45, kurz vor dem Opening. Die ersten Code-Commits tragen 12:38, offizieller Start war 13:00. Das stand so im README der Abgabe. Das ZIP ging am Ende ohne Git-Historie raus, die Uhrzeiten standen deshalb dort und im Log. Umgeschrieben hab ich nichts.
Ob vorbereiteter Code erlaubt ist, war eine meiner drei Fragen für Sonntag. Geklärt hab ich sie nicht. Deshalb steht die Abweichung offen drin, statt dass ich sie erkläre, wenn jemand fragt.
Auch die Idee war früher fix als angekündigt. Gewählt hab ich nicht beim Opening, sondern schon am Freitag um 15:26: Pflegegeld. Bis 17:34 kam die Schärfung: nicht mehr die Stufe schätzen, sondern den Bescheid nachrechnen. Ein Bescheid hat eine Stundenzahl, eine Stufe und eine Frist. Das lässt sich nachrechnen.
Ein Ansprechpartner, viele Agenten
Gebaut hab ich solo, mit Agenten. Drei Sessions haben je einen Bereich übernommen: Rechenkern und Messung, die Zuordnung mit KI, die Oberfläche. Eine Koordinator-Session hielt Schnittstellen, Testfälle und README zusammen. Darüber lief eine Beobachter-Session, und das war eigentlich die einzige, mit der ich geredet hab. Ich hab getestet, Feedback gegeben und die nächste Version wieder getestet. Richtung, Name und das, was der Prüfer behaupten darf, blieben bei mir.
Zusammengeführt wurde nur zur vollen und zur halben Stunde. Trotzdem war main zweimal rot. Einmal von 15:34 bis 16:00, einmal von 17:02 bis 17:11. Beide Male waren die einzelnen Änderungen für sich grün, nur zusammen nicht. Ab 17:05 hat deshalb eine Session vor jedem Fenster main und alle Kandidaten gemeinsam geprüft.
Im Vorher-Post hab ich Punkte angekündigt, an denen ich kürze statt weiterzubauen. Es waren zwei, 16:00 und 23:00. Den ersten hat das Projekt um 16:02 bestanden. Um 17:00 kam der Name. Aus dem technischen Arbeitstitel wurde Pflegegeld-Prüfer, weil die Zielgruppe verstehen soll, was das ist, bevor sie klickt. Den zweiten Punkt hab ich um 22:37 abgenommen, mit dem kompletten Ablauf im Browser.
Bis zur Abgabe standen 885 Commits im Verlauf, davon 330 Merges, dazu 142 Issues und 205 gemergte Merge Requests. Zwischen dem ersten Code-Commit und dem letzten Commit liegen rund 15,5 Stunden. Das ist gemeinsame Arbeit mit Agenten, Dokumentation inklusive.
17:47: Rosa landet eine Stufe zu tief
Um 17:47 meldet eine Helfer-Session: Rosa landet über die Oberfläche bei 153 Stunden. Das ist Stufe 3. Ihr erfundener Fall ist auf 163 Stunden und Stufe 4 angelegt. Mit dem vollen Transkript trafen alle fünf Beispielfälle. Über die Oberfläche fehlten Rosa zehn Stunden.
Meine Entscheidung damals: Die Rückfragen zielen auf die Stunden, die zur nächsten Stufe fehlen. Bei Bedarf gibt es eine zweite Runde mit höchstens sechs Fragen. Und die Anzeige geht nie unter den Bescheid. Ein Ergebnis unter dem Bescheid wäre eine falsche Botschaft an eine Familie.
Nach der Änderung kam Rosa nach fünf Fragen in zwei Runden auf 163 Stunden, Stufe 4.
Die Zahl, wie versprochen
Im Vorher-Post hab ich angekündigt, die Bewertung nach dem Event zu zeigen. Hier ist sie.
Das Ziel stand am Samstag um 12:38 im Repository, mit den ersten Commits und viereinhalb Stunden vor dem ersten Lauf der App. Mindestens 12 von 14 veröffentlichten Gerichtsfällen sollten exakt die richtige Stufe treffen. Richtig heißt meist die Stufe aus dem Urteil. Bei Kindern ist richtig, gar keine Stufe auszugeben, sondern einen Hinweis. Am Freitagabend gab es schon eine erste Vorregistrierung, die galt aber nur für den Modellvergleich.
Der erste Lauf der App um 17:13 traf 9 von 14. Um 19:01 hab ich Regeln und Prompt eingefroren. Ab da wurde auf diesen Fällen nichts mehr getunt. Dann der Endlauf, drei Läufe pro Fall: 10 von 14. Das 95-%-Intervall liegt bei 45 bis 88 %. Ziel verfehlt.
Zwei der vier Fehler liegen zu niedrig, weil eine Position offen blieb. Einmal hat der Prüfer ein Kind nicht als außerhalb seines Umfangs erkannt. Und dann ein Fall, blind und beinamputiert, den das Gericht auf Stufe 4 gesetzt hat. Er endet in allen drei Läufen bei Stufe 1, weil der Prüfer die Mindeststufe bei Blindheit übersieht. Zu hoch lag er bei diesen 14 Fällen kein einziges Mal.
Zählt man mit, ob er die entscheidende Rückfrage stellt, sind 13 von 15 Fällen gelöst. Das Ziel dafür lag bei 13 und war erreicht.
Dann das zweite Testset mit 15 weiteren Fällen, einmal gemessen nach 22:30: 5 von 15, Intervall 15 bis 58 %. Deutlich schlechter. Zweimal lag er dort zu hoch. Und der Bescheid traf auf diesen Fällen öfter als mein Prüfer, in 8 von 14. Ein Blindtest war das auch nicht. Die Fälle liefen schon im Modellvergleich mit, und ein Teil der Regeln stammt aus ihnen.
Die Baseline ist der ursprüngliche Bescheid. Er traf in 16 von 29 Fällen die Stufe aus dem Urteil, alle 13 Fehler lagen zu niedrig. Direkt vergleichbar ist das nur eingeschränkt.
Am Montag hab ich noch das Modell gegengemessen, das auf der Website läuft. Gemini 3.8 Flash kam auf dieselben 10 von 14, mit denselben vier Fehlfällen. Hätte ich das Ziel erst nach dem Lauf aufgeschrieben, hieße es jetzt vermutlich 10. Genau dafür schreibt man es vorher auf. Alle Fälle einzeln, samt Fehlern, stehen auf der Methodik-Seite.
Nach Mitternacht: Freeze, und dann doch nicht
Nach dem zweiten Punkt um 22:37 stand die Frage aus dem Vorher-Post im Raum: kürzen oder weiterbauen? Ich hab mich für Ausbau entschieden. Unter anderem kam eine Karte dazu, mit der du unsichere Positionen bestätigst oder abwählst.
Um 00:48 stand der Freeze, das letzte Merge-Fenster war um 01:30. Um 02:12 hab ich ihn wieder aufgehoben, soweit es der App nützt. Der letzte Commit trägt 04:12. Das war gegen den eigenen Plan, und so steht es auch im Log.
Dazwischen entstand das Video. "Beim Video hatte ich auch einen hundertprozentig agentischen Weg genommen", hab ich am Sonntag im Rückblick gesagt. Agenten haben Folien, Screenshots und den Schnitt gebaut. Ich hab um 03:25 Bildschirm und Stimme aufgenommen und um 04:49 nachgesprochen.
Zwei Gewinner an einem Tisch
Angemeldet war ich solo, gesessen bin ich in einer Vierergruppe, mit Helena, Hayat und Julian. Wir haben am selben Tisch gebrainstormt, geredet und den Abend miteinander verbracht. Gebaut hat jede Seite ihr eigenes Projekt. Ihres heißt miRacle und hat sich den Sieg in Track B3 geteilt. Zwei Gewinner an einem Tisch, das taugt mir.
Dass neben dem Bauen Platz für so einen Abend war, hat mit der Arbeitsweise zu tun. Ich hab nicht jede Session einzeln gesteuert, sondern getestet und Engpässe aufgelöst. Verteilt hat die Arbeit die Beobachter-Session.
Drei Fragen, drei Antworten
Drei Fragen hab ich am 23.09. mitgenommen.
Hat mir in der Nacht etwas gefehlt, das ich vorher hätte vorbereiten dürfen? Ja, zwei Dinge. Der gemeinsame Test vor dem Merge kam erst nach dem zweiten roten main. Und es fehlte der Kontakt zu einer echten Person aus der Zielgruppe. Den Nutzertest, den Track A1 eigentlich verlangt, hab ich nicht geschafft. Der Nachweis läuft über Gerichtsfälle und erfundene Familien, und genau so steht es auch in der Abgabe.
Geht sich in 19,5 Stunden ein gemessenes Ergebnis mit Baseline aus? Ja. Eine kleine echte Zahl mit Intervall und eine Baseline aus fremden Bescheiden. Größer ist die Aussage nicht, und klinisch geprüft ist daran nichts.
Was sagt das Opening zu vorbereitetem Code? Das hab ich nicht geklärt. Meine Antwort ist die offene Zeitleiste im README der Abgabe.
Sonntagnachmittag: der Pflegegeld-Prüfer geht live
Noch am selben Nachmittag ging der Prüfer unter eigener Domain live, mit Impressum, Datenschutzerklärung und einer Einwilligung, bevor eigener Text an den KI-Dienst geht. Die Texte sind jetzt für echte Besucherinnen und Besucher geschrieben.
Der nächste Schritt ist ein Feldtest mit einer Fachperson aus der Pflegeberatung und mit pflegenden Angehörigen. Bis dahin bleibt der Prüfer, was er ist: Vorbereitung auf ein Gespräch.
Am 3. und 4. Oktober ist Hack-Nation 7, wieder im HOIV, und am Wiener Hub bin ich angemeldet. Mit kommen der gemeinsame Test vor jedem Merge, eine einzige Session als Ansprechpartner und die Vorregistrierung. Der Code vom Pflegegeld-Prüfer bleibt daheim, mit kommt nur, was ich dabei gelernt hab. Und wenn ich früher anfange, sag ich es diesmal vorher.
Wenn du jemanden kennst, der gerade einen Pflegegeld-Bescheid vor sich liegen hat, schick den Link weiter. Wie ich im Alltag mit Agenten arbeite, steht auf der Startseite. Und wenn du Rückmeldung zum Prüfer hast, schreib mir.