Ein Warnsignal darf nur warnen, wenn es selten ist
Eine RAM-Warnung feuerte auf 84 Prozent aller Session-Starts, bei null OOM-Fällen. Die Korrektur war nie die Schwelle, sondern die Messgröße.
TL;DR
Vier Monate lang hat mein Session-Start fast immer gewarnt. Gemessen über 1.477 Session-Starts in 18 Repos: irgendeine der drei Ressourcen-Warnungen feuerte auf 99,0 Prozent der Starts, die RAM-Warnung allein auf 84,0 Prozent. Im selben Fenster stehen 4.884 beendete Sessions, darin null OOM-Marker und null ENOSPC, also kein einziger Abbruch wegen vollem Speicher und keiner wegen voller Platte. Die Ursache war nicht die Schwelle, sondern die Messgröße: os.freemem() meldet auf macOS nur die freien Pages, und die liegen im Median bei 0,4 GB, auch auf Rechnern mit 128 GB. Wer an so einer Warnung die Schwelle dreht, repariert nichts. Drei Kommandos genügen, um den Fehler auf dem eigenen Rechner in zwanzig Sekunden zu sehen.
Was eine Warnung eigentlich leisten muss
Eine Ressourcen-Warnung existiert, um eine Entscheidung zu ändern. Eine Welle verkleinern. Eine zweite Session hintanstellen. Aufhören, bevor der Rechner einfriert. Wenn keine dieser Entscheidungen anders ausfällt, war die Warnung ein Geräusch. Der Satz, der heute in meinen Regeln steht, ist deshalb bewusst hart formuliert: eine Warnung, die auf fast jeder Session feuert, ändert nichts außer der Geschwindigkeit, mit der man lernt, sie zu ignorieren.
Das gilt genauso für jedes Dashboard, dessen rote Kachel seit Monaten rot ist.
Daraus folgt eine Zahl, und die ist der eigentliche Ertrag. Überschreitet eine Warnklasse etwa 10 Prozent Feuerrate, ist das Instrument defekt und nicht die Welt. Dann richtet man das Instrument neu aus. Man gehorcht ihm nicht, und man schaltet es auch nicht stumm. Beides fühlt sich nach Fortschritt an und ist keiner: Gehorchen heißt, dauernd Kapazität wegzunehmen, die man hat. Stummschalten heißt, das Loch zuzukleben und die nächste echte Warnung mit zu verlieren.
Die Gegenrichtung ist genauso verdächtig. Eine Klasse, die über ein paar hundert Stichproben auf 0 Prozent steht, ist entweder wirklich selten oder still kaputt, und von außen sehen beide Fälle identisch aus. Das ist der Grund, warum ich die Feuerraten überhaupt speichere und nicht nur die Verdikte.
Die Messung, die den Alarm entlarvt hat
Der Anlass für das Gate war echt. Am 19.04.2026 fror mein Arbeitsrechner über acht parallele Sessions ein, dazu kamen zwei OOM-Abbrüche in Worktrees. Das Gate war also keine Erfindung aus Langeweile, sondern die Reaktion auf einen Tag, an dem mir die Maschine unter den Händen weggestorben ist.
Vier Monate später habe ich nachgezählt. 1.477 session.started-Events über 18 Repos, Fenster vom 19.04.2026 bis zum 21.08.2026, ausgewertet am 21.08.2026. Die Feuerraten:
ram_free_gb < 2: 84,0 Prozentclaude_processes >= 5: 93,6 Prozentcpu_load_pct > 80: 15,6 Prozent- irgendeine der drei: 99,0 Prozent
Die Gegenprobe kommt aus denselben Daten: 4.884 beendete Sessions im selben Fenster, null OOM-Marker, null ENOSPC. Ein Gate, das auf 99 von 100 Starts warnt und dessen Katastrophe in 4.884 Fällen nie eintritt, ist kein Frühwarnsystem. Es ist Tapete.
Sechs Repos hatten den Fehlalarm übrigens unabhängig voneinander in ihre eigenen Learnings geschrieben, eines davon mit Konfidenz 1,0. Das Wissen war da. Es war nur nirgends aggregiert, und deshalb hat es vier Monate lang niemanden zu einer Korrektur gezwungen.
Warum os.freemem() auf dem Mac das Falsche misst
Der Fehler steckt eine Ebene unter der Schwelle. os.freemem() gibt auf Darwin die freien Pages zurück, sonst nichts. Inaktive Pages, spekulative Pages und aufräumbarer Cache zählen nicht mit, obwohl das Betriebssystem sie jederzeit hergibt. Auf Hosts zwischen 24 und 128 GB liegt der Median dieser Zahl bei 0,4 GB. Eine Schwelle von 2 GB ist dagegen chancenlos.
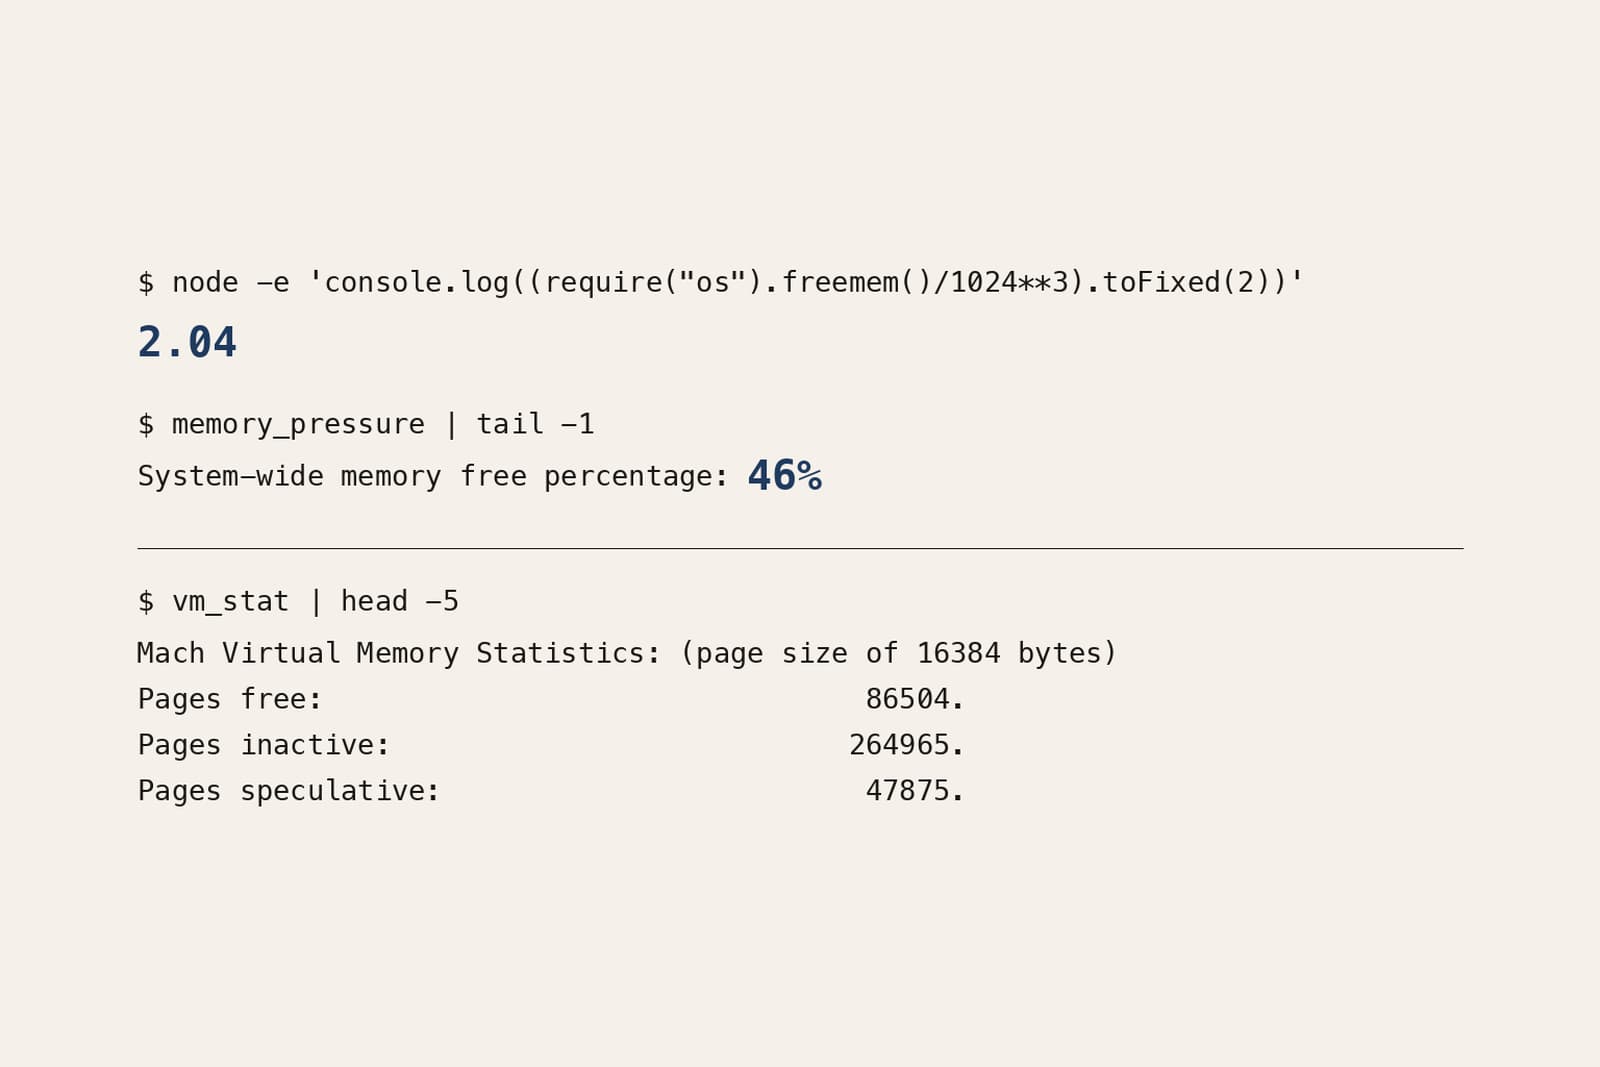
Das lässt sich in drei Zeilen nachstellen. Heute, auf meinem Arbeitsrechner mit 24 GB:
node -e 'console.log((require("os").freemem()/1024**3).toFixed(2))'
# 2.04

memory_pressure | tail -1
# System-wide memory free percentage: 46%

vm_stat | head -5
# Pagesize 16384, Pages free 86504, Pages inactive 264965, Pages speculative 47875
2,04 GB angeblich frei auf 24 GB, gegen 46 Prozent frei laut Betriebssystem. Das ist der ganze Fehler in zwei Zeilen, und die dritte erklärt ihn: die inaktiven und spekulativen Pages sind zusammen ein Vielfaches der freien. Mach das auf deinem eigenen Rechner nach, bevor du irgendeiner Speicher-Heuristik glaubst, die auf freemem aufsetzt.
Die Korrektur war entsprechend keine neue Zahl, sondern eine Rangfolge. Zuerst der Prozentwert aus memory_pressure, dann eine berechnete Verfügbarkeit aus vm_stat, und erst wenn beides fehlt, die freien Pages. Die Verfügbarkeit rechnet sich als Summe aus freien, inaktiven, spekulativen und aufräumbaren Pages mal Pagesize. Dateigestützter Cache bleibt bewusst draußen, weil er unter Druck nicht verlustfrei zurückkommt. Auf Linux und Windows meldet os.freemem() übrigens das Richtige, deshalb bleibt es dort der Fallback und wird nicht ersatzlos entfernt.
Ein Signal darf nur warnen, wenn es selten ist.
Der Halb-Fix, der das Loch offen ließ
Die erste Fassung der Korrektur war nicht falsch, nur zu höflich. Sie unterdrückte die Free-RAM-Warnung genau dann, wenn der Speicherdruck gerade gesund war, festgemacht an einer Konstante von 30 Prozent freiem Druck. Klingt vernünftig. Das Band darunter blieb aber weiter auf den freien Pages: sobald überhaupt Druck vorhanden war, entschied wieder die Zahl, die auf diesem Betriebssystem systematisch daneben liegt. Ausgerechnet in dem Bereich, in dem die Entscheidung zählt, war das Instrument unverändert kaputt.
Ein besseres Signal ersetzt ein schlechteres, es unterdrückt es nicht bloß. Unterdrückung ist ein Pflaster, Präzedenz ist die Reparatur. Der Unterschied klingt akademisch, ist aber der Unterschied zwischen einer Regel, die man in einem halben Jahr wieder aufmacht, und einer, die hält.
Ein Signal reicht nicht, und nicht jedes darf zählen
Der zweite Teil der Reparatur betrifft die Verknüpfung. Heute löst ein Verdikt nur aus, wenn entweder ein hartes Signal anschlägt oder zwei unabhängige weiche gleichzeitig. Der Grund dafür sind zwei Beobachtungen aus den Daten.
Erstens misst eine Prozesszählung nicht das, wonach sie aussieht. Das Verhältnis von Claude-Prozessen zu tatsächlich laufenden Sessions liegt im Median bei 6,0, gemessen über 1.461 gepaarte Stichproben. Ein Schwellwert von fünf Prozessen ist also ungefähr eine Session. Dieselbe Zahl mit der richtigen Einheit, peer_sessions >= 5, feuert auf 4,2 Prozent statt auf 93,6. Vor der Schwelle gehört die Einheit geprüft, nicht danach.
Zweitens taugt nicht jedes Signal als zweite Meinung. Zombie-Prozesse aus abgebrochenen Läufen sind bei mir ein Dauerzustand: 6, 13 und 9 in drei Messungen wenige Minuten auseinander. Wer sie mitzählt, hat kein zweites unabhängiges Signal, sondern dasselbe Rauschen doppelt. Wie ich diesen Dauerzustand separat einfange, habe ich in Eine Menubar-App killt meine Zombie-Prozesse beschrieben. CPU-Last ist ebenfalls kein Alleinentscheider: eine Spitze fiel in einer Messung binnen 36 Sekunden von 96 auf 75 Prozent. In der Simulation feuert cpu > 90 AND peers >= 3 auf 2,2 Prozent, peers >= 4 allein auf 7,4 Prozent. Beide Werte liegen unter meiner 10-Prozent-Linie, die Kombination deutlich.
Auch Swap taugt nicht als Schreckensbild. Ein Referenzhost trug 6,9 GB belegten Swap bei 35 Prozent freiem Druck, ohne jedes Thrashing. Swap ist ein Werkzeug des Betriebssystems, kein Notruf.
Dazu kam ein dritter Zustand. Wenn eine Sonde nicht lesbar ist, ist das nicht grün. Vorher fiel ein unlesbarer Wert stillschweigend auf harmlos zurück, und ein kaputtes Messgerät sah aus wie eine gesunde Maschine. Heute hat unlesbar einen eigenen Zustand mit eigenem Grund, aus einem eingefrorenen Enum, damit sich die Gründe nicht wieder in Freitext auflösen.
Zwei kleinere Befunde runden das ab, und beide sind peinlicher als der eigentliche Bug. Das Verdikt erreichte die Session-Historie nur für 15 von 1.734 Sessions, also 0,9 Prozent. Vier Monate lang war die eigene Regel damit praktisch nicht widerlegbar, weil die Daten zum Widerlegen nie gespeichert wurden. Und der Banner, den ich beim Start tatsächlich sehe, hatte fünf Emitter und vier Zeilen, von denen genau eine angezeigt wurde. Welche Zahl das Verdikt treibt, muss die Zahl sein, die man sieht. Diese Art von Verdrahtungslücke ist ein Muster, das ich inzwischen aktiv suche, nicht ein Einzelfall, wie ich in Harness Design für produktive KI-Coding-Agenten schon einmal ausgebreitet habe.
Was ich daraus mitnehme
- Eine Warnklasse über etwa 10 Prozent ist ein defektes Instrument. Nicht die Umwelt ist zu laut, die Messung ist falsch ausgerichtet. Und eine Klasse auf exakt 0 Prozent verdient dieselbe Skepsis.
- Ein besseres Signal ersetzt ein schlechteres. Unterdrücken ist ein Pflaster, Präzedenz ist die Reparatur. Ein Halb-Fix, der nur den gesunden Bereich abdeckt, lässt genau den Bereich offen, in dem entschieden wird.
- Vor der Schwelle die Einheit prüfen. Prozesse sind keine Sessions, Faktor 6,0 im Median. Dieselbe Zahl in der richtigen Einheit fiel von 93,6 auf 4,2 Prozent.
- Wer die Feuerrate nicht speichert, kann seine eigene Regel nicht widerlegen. 0,9 Prozent persistierte Verdikte heißt vier Monate blindes Vertrauen in eine Heuristik.
- Unlesbar ist nicht grün. Ein kaputtes Messgerät braucht einen eigenen Zustand, sonst tarnt es sich als gute Nachricht.
Fazit
Die kleinste Zahl dieser Geschichte ist 0,4 GB. So viel meldet macOS im Median als frei, egal ob 24 oder 128 GB verbaut sind, und genau diese Zahl hat vier Monate Fehlalarm getragen. Sie ist unspektakulär, sie steht in keiner Release-Notiz, und sie hat mehr erklärt als jede Schwellwert-Diskussion davor.
Wenn du selbst Gates baust, die deine Agenten drosseln sollen: zähl die Feuerrate, bevor du an einer Schwelle drehst. Ein Zähler pro Warnklasse reicht. Wie das Verfahren drumherum aussieht, in dem solche Gates sitzen, steht in Wie session-orchestrator als OSS-Tool in 9 Tagen reift und in Eine Agenten-Flotte: Sven, BuilderBob und ihr Loop. Womit ich sonst arbeite, steht unter Werkzeug, wie ich dabei vorgehe unter Arbeitsweise.